AIエージェントに仕様書と決定記録を必要なときだけ読ませる試み
私は最近、ストリーミング音声認識APIを使ったMac向け文字入力アプリ「Whistt」を開発しています。このアプリのリポジトリでは、今までの経験を踏まえて、作業に必要な開発ドキュメントをAIエージェントに自動で読み込ませる手法を検証しています。
この取り組みの狙いは、少ない人数で、より大きな範囲のソフトウェアを作ることです。そのためには、仕様の決定や技術的判断の経緯を、必要なときにAIに読み込ませる必要があります。
仕様書と意思決定記録の役割を分ける
Whisttは、まずバイブコーディングでプロトタイプを実装し、その後で仕様書を整えました。立ち上げ時には、仕様書を先に作り、それをもとに実装を生成する仕様駆動開発(SDD)の進め方は採っていません。
仕様書は当初、Macアプリの一連の操作のうち、自動テスト化できていない部分を手で一つひとつ確認するためのチェックリストとして使っていました。QAフェーズで使うこうした項目は、今まではMarkdownの箇条書きやExcelシートにして、目視で確認していました。これをAIから使いやすいように、振る舞いや条件を一定の書式で書くGherkinやEARS記法で記述したいというのが着想です。
仕様書には、AIエージェントと議論して合意したアプリの振る舞いと受け入れ条件を書きます。これは、要件定義でユーザーと開発ベンダーが交わす約束に近いと思います。ここでは私がユーザーで、エージェントが開発ベンダーです。
意思決定記録(ADR)には、開発側のアーキテクトや開発者の設計意図を記録します。コードに残らない情報をドキュメントとして残す、という基本方針があります。
これらのドキュメントは、当初はすべて docs/specs/ に詰め込んでいました。
ところが、AIエージェントがドキュメントを参照する振る舞いを観察すると、一緒に置いていた過去のADRによって動作が変わってしまうことに気づきました。docs/specs/ は、grepや検索など、何らかのきっかけでエージェントが読み込む可能性があります。
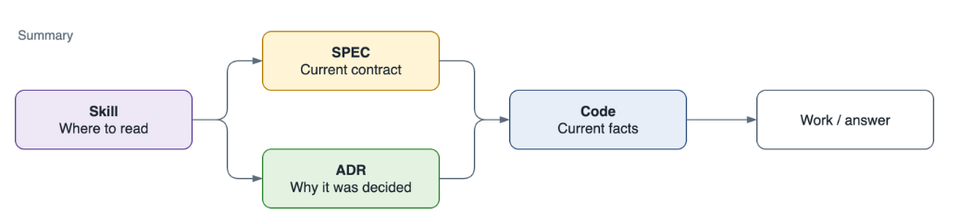
そこで、仕様書は docs/specs/ に残し、ADRはエージェントスキルの配下に移して、スキル経由で参照させるようにしました。スキルは、一般的なプロジェクトの文脈を扱う whistt-context と、ADRを参照するための whistt-decisions の2つに分けています。
ADRはログなので、新しい記録がどんどん積み重なります。AIエージェントがそれをまとめて読み込む必要はありません。そこで目次を作り、スキルが必要な文書だけを段階的に読み込む仕組みを使って、今の作業に関係するものだけを参照させています。
スキルが使われるかを検証する
このリポジトリ構成は、実験を繰り返して決めました。実験では、それまでの会話のコンテキストを持たないサブエージェントに指示を与え、どのように動作するかを観察します。例えば、音声入力の方式を長押しからトグル式に変えるという架空の機能改修について、設計上の判断を依頼しました。この段階では実装はせず、プランニングのための調査をしてもらいました。
サブエージェントはスキルを自動で読み込み、まず whistt-context からホットキーの仕様書を参照しました。続いて目次から関連するADRを読み、ストリーミングの開始と停止をキーで制御するイベントについて、過去のデバッグやバグ修正から学んだ情報を参照していました。ADRは複数ありますが、関係のないADRは読みませんでした。
このプランニングを含めた全体の動作フローが以下です。
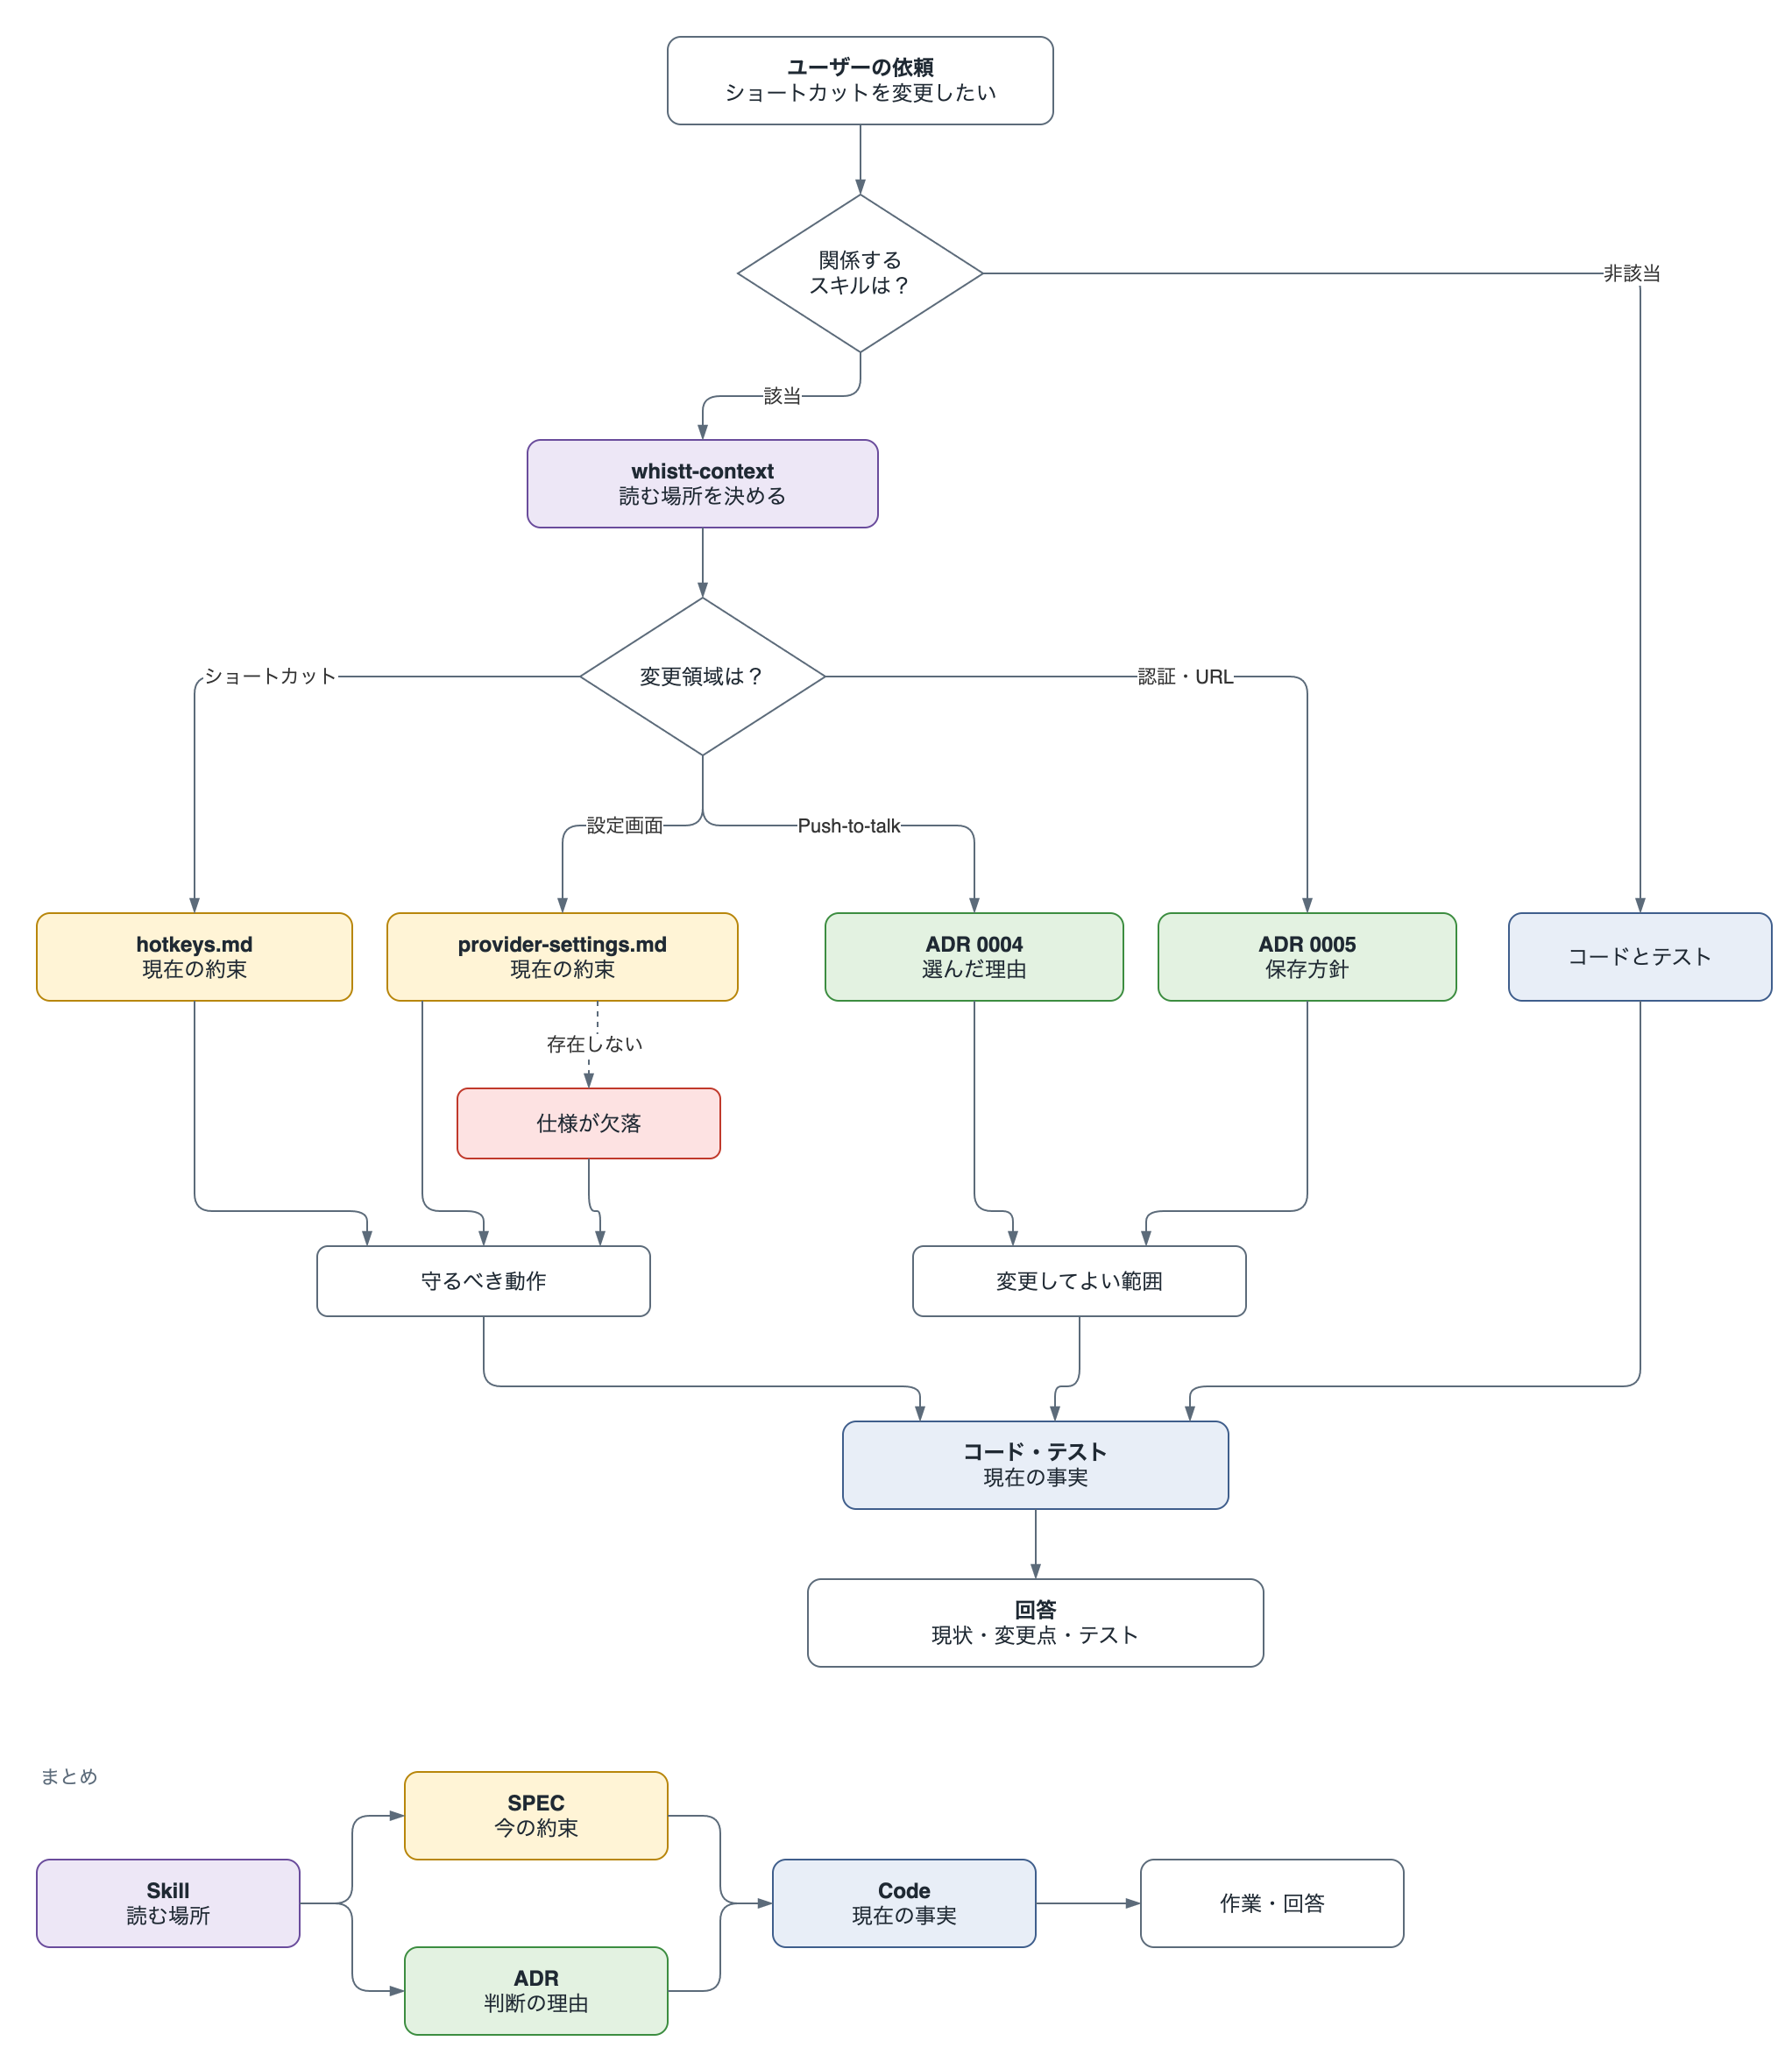
別のプランニングタスクでは、Microsoft Azureの接続設定を題材に、仕様書の記述不足を洗い出してもらいました。エンドポイントの入力欄はすでに実装されていましたが、それに対応する設定画面の仕様が文書化されていないことをサブエージェントが指摘しました。この指摘をもとに、設定画面の仕様書を新たに作ることにしました。
別の開発者のエージェントが書いた仕様
設定画面をめぐっては、外部の開発者からも、エージェントが実装に合わせて仕様を追加したという報告がありました。設定画面のUIを追加するプルリクエストを送ってくれたwozozoさんによると、エージェントはGherkinを使うよう明示的に指示しなくても、仕様書にGherkinのコードブロックを追加したそうです。
このプルリクエストの仕様書には、画面構成や振る舞いに加え、Keychainに保存したAPIキーを画面に表示しないことや、システムへのログイン時にアプリを起動する設定などが記述されています。私はこのプルリクエストを受け取り、テストの追加などを行ってマージしました。
仕様書に残す範囲と手動テスト
一方で、仕様記述を厳密にパターン化すると、冗長になりがちです。アプリが持つすべての振る舞いを文章化しても、それを管理しきれる自信がありません。実際、以前に別のプロジェクトでSDDを試したときは、仕様の管理が破綻しがちでした。そのため、仕様書には手動で確認する振る舞いだけを残すことを重視しています。
今回の設定画面の開発でも、保存や失敗時の処理など、ロジックのレベルで検査できるものは自動テストコードに分離し、仕様書をスリムに保ちました。macOSの権限画面との連携は、このプロジェクトでは自動テスト化できていないため、仕様書に書いて手でテストしています。現在、Gherkinなどの記述はこの手動テストを支えるために使っています。
開発時には、この手で触る部分を先に実装して確認します。後回しにすると、人間の確認待ちで開発が止まるためです。そこが決まったら、残りをエージェントにバックグラウンドで渡し、自律的に進めてもらいます。Mitchell Hashimotoは自身のブログで、終業前にエージェントへ調査やアイデアの試行を依頼し、翌朝の作業に役立てる習慣を紹介していました。確認が要る部分を先に済ませ、残りをエージェントに渡す点で、私の進め方もこれに近いものです。
将来は、Gherkinなどの仕様記述をもとに、エージェントがComputer Useなどの自動操作でQAを行えるようになると見込んでいます。
さらに、仕様書ディレクトリにある自然言語のドキュメントを論理的にチェックし、仕様書そのものの品質を高める作業も自動化できないかと考えています。仕様同士に矛盾がないか、意思決定記録に反した仕様になっていないかを検査するために、形式手法や仕様記述への理解を深め、ハーネスに検査の仕組みを組み込んでいきたいです。
設計と実装を別のエージェントに任せる
設計と実装でも、文書を介してエージェントに作業を渡しています。
設計や人間との議論には、ChatGPT WorkでGPT Solを使っています。同じセッションでPlan modeから実装へ進む方法もありますが、Whisttでは実装をZCode(Z AI)のGLM 5.3 Flashに任せたかったため、設計と実装のセッションを分けました。GPT側で書き出したプランファイルを、大きなプロンプトとしてそのままZCodeに渡します。
GLM側では、プランファイルをもとに、ZCodeの /goal で実装を完了するまで進めてもらいます。その間、私の操作は入りません。この分担はうまくいっています。
実装ができたら、設計を詰めたコンテキストが残っているGPT Solのセッションに戻り、/review でレビューを依頼します。設計を担当した側が、その意図どおりに実装されているかを確認できるため、レビューの品質も高く感じます。
レビュー後は、実装したGLM側に差し戻さず、GPT側でそのまま修正します。修正する側にも高性能なモデルを使いたいためです。人間の開発なら、実装者に修正を戻すことはチームの学習やスキルアップにつながります。一方、AIエージェントは今のところ、フィードバックをもとに改善しません。そのため、実装者の学習を目的に差し戻す意味がありません。
現在は、この流れを一人で、すべてローカルで行っています。次はクラウドで動かし、成果物をプルリクエストとして出すところまで進めたいと考えています。その先には、仕様書を次々と作り、実装側に渡すパイプラインを構想しています。
関連する取り組みと書籍
こうした仕組みは、私が突然思いついたものではありません。SDD以外にも、ハーネスエンジニアリングやループエンジニアリングといった名前で、関連する取り組みが盛んに議論されています。
この辺りを調べ直したのは、Kiroの最近の動向を追っていたときです。Kiroが仕様駆動開発を打ち出してから一年ほど経ち、ユーザーが実際にどう使っているのかが気になりました。私が見た範囲では、KiroやGoogleのAntigravityは、プランニング段階のドキュメント生成をワークフローにし、その生成物を人間が確認して制御するという路線です。
これに対して、Addy Osmaniが「Loop Engineering」で述べているのは、エージェントに指示するだけでなく、仕事を見つけ、指示を出し、結果を確認する仕組みを作るという話だと理解しています。私がWhisttでやりたいのは、もっと規模の小さい具体的な実験です。一つのタスクに対して、読ませる文書やコンテキストを揃える作業をどこまで減らしてもうまくいくのか、手元で少しずつ試したいと考えています。
SDD、ハーネス、ループのいずれにも、開発のどの段階に人間が仕組みを設けて自動化するか、という共通の問題意識があると思います。名前の違いには深入りせず、そこで扱われている問題や解決策の考え方を持ち帰れれば十分だと考えています。
近い話題の書籍で、最近読んで感銘を受けたのが、『情熱プログラマー』の著者Chad Fowlerが執筆している『Regenerative Software』です。私が読んだ時点ではO’ReillyのEarly Release段階で、まだ全章は揃っていませんが、執筆途中の内容を読めます。
この本では、AIによるコード生成を、コンパイラが機械語を生成する工程になぞらえ、そこから具体的な議論を展開しています。実装を生成し直しても保つべき部分と、生成によって変わる部分を分け、仕様や設計上の制約をもとにソフトウェアを作っていく新しいやり方を提案していると感じました。単に仕様書からコードを生成する手順や、開発を自動化する方法として読むだけでは、捉えきれない内容です。Whisttで仕様書とADRをコードと分けて残しているのは、この「生成し直しても保つべき部分」にあたると考えています。
ほかにも、O’Reillyの『AI-Native Software Engineering』や、Addy Osmaniの『Agentic Engineering』など、仕様をもとにしたコード生成を扱う書籍が出てきています。
今後の開発に向けて
今後は、Whisttやそれ以前のプロジェクトで得た経験をもとに、より大きなプロジェクトに挑んでいきたいと考えています。エージェントにどこまで任せ、人間がいつ判断や確認をするのか。今回の構成で試しているのは、その線引きを文書の置き場所と読み込み方で決めることです。この線引きを、より大きな範囲のソフトウェアでも成り立たせたいと考えています。
読者の皆さんのプロジェクトで、実際にうまくいったコンテキストの渡し方や、文書の読み込みパターンがあれば、ぜひ教えてください。
