Geminiに文章執筆を任せるスキル「Gemini Write」を作った

はじめに Gemini 3.8 Flashがリリースされた時に、日本語作文の能力を高く評価する評価をよく見かけました。 筆者もいくつかの例で試したのですが、特にClaudeやGPTと比べて優れてるとはその時は思いませんでした。 そこでさらに調べるために、同じ筋書きから近い価格帯の3モデルで文章を作成してブラインドテストで好みの文章を探るという実験をしました。 その過程でできたエージェントスキルを紹介します。 Gemini Write 「Gemini Write」は普段使っているCodexやClaude Codeから、文章を書く作業だけGeminiに任せるというスキルです。材料と指示を外部のagyコマンド(Antigravity CLI)に渡し、生成された文章をファイルで受け取ります。 GitHub - laiso/gemini-write: Delegate drafting, rewriting, or proofreading of

ChatGPT SitesにVinextアプリをデプロイする

ChatGPT Sitesは、ChatGPTとした会話をもとに自動でWebサイトに書き出すための機能です。ClaudeのArtifactsがWebページや小さなアプリを手軽に作る仕組みなのに対し、Sitesではバックエンドのコードやデータベース、ストレージを含むWebアプリケーションをデプロイできます。 Sites – ChatGPT | ChatGPT LearnBuild and share a website by describing it in ChatGPT or CodexChatGPT Learn 本記事では、会話の内容からではなく、手元で作ったWebアプリケーションをSitesへデプロイします。自作のニュースリサーチエージェントを例に、ローカルでコードを編集し、ビルドしてチェックしたものをSitesで動かすまでを説明します。 Sitesではデータベースとストレージも使うことができます。以下のサンプルでは、スケジュール実行と組み合わせて、AIが調査して結果を保存する処理につなげます。 手元で作ったアプリをデプロイする

#22 Jevその後

9月に紹介した Jev やローカルモデルによる分類の検証以降、判断・分類タスク向けに特化したAPIや独自モデルを学習するためのツールが相次いで登場しています。 おさらいすると、判断(もしくは意思決定・Decisions)モデルとは、コンテキストの状態と質問、選択肢の候補を入力として受け取り、その判定結果をプログラムの制御フローで直接利用することを想定したモデルです。従来の汎用LLMや分類器でも選択や分類の実装自体は可能でしたが、高速で安価なAPIエンドポイントや派手なデモで有用性がアピールされたことで、利用や運用の選択肢が具体的に広がりました。 要約 * Jevやオープンウェイトの判断モデルに加え、OpenAI・Cloudflare・Microsoftも判断APIを提供するようになった。 * 利用できるモデルや構築ツールは増えたが、どの処理に組み込むと有効かは、まだ試行錯誤。 * 基盤モデルもQwen系だけでなく、Liquid独自のLFM系やBERT系など、複数の系譜に広がっている。 OpenAIのDecisions API OpenAI は、事前に定義した候補から

説明スキルの比較:ELI5、Archify、Explainer

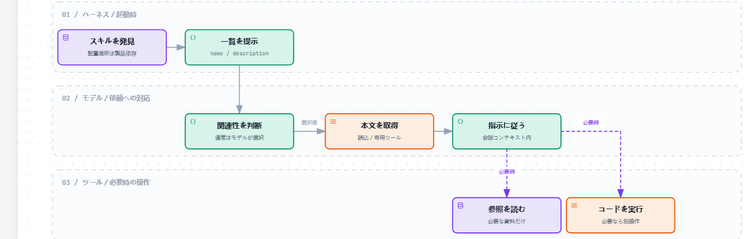
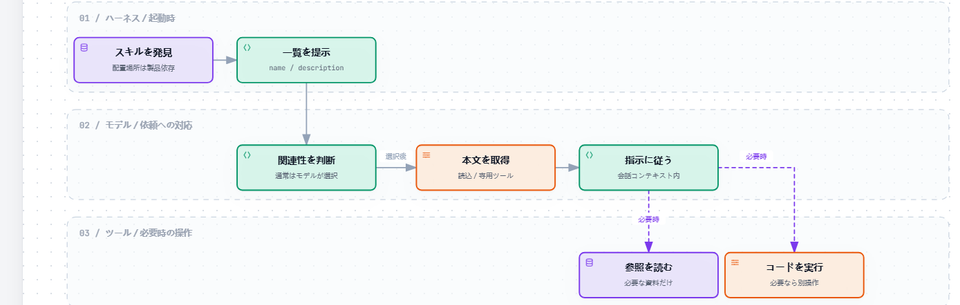
Anthropicのコミュニティプラグイン用リポジトリに、ELI5というスキルが公開されています。これは大きな絵と少ない言葉を使ったHTMLで、対象を視覚的に説明するスキルです。 私たちがAIに仕事をどんどん任せている一方で、コーディングではソースコード本体を読む機会が減り、より上位レイヤーの構造を自然言語で記述するようになってきています。その際、ドキュメンテーションとしてAIが書き出す文章も、多くは冗長で専門的な語彙や会話のコンテキスト汚染があり、前提知識に頼った認知負荷の極めて高いものになりがちです。 ELI5はClaudeの目玉機能であるArtifactsのデモとして公開されたと解釈できそうですが(参考:AI時代のリッチテキスト形式(RTF))、こうした説明系のスキルはその負担を減らすため受け入れられているものだと考えています。 筆者も最近はこのようなスキルを積極的に試しています。本記事ではその中から特徴の異なる3つのスキルを紹介し、実際にAgent Skillsの仕組みの説明を生成して比べてみます。 絵本のように説明するELI5 ELI5は前述のとうり絵と少ない言葉

System One Adapterを使ったJevとローカルモデルの分類タスク比較

前回の記事では、文章を渡すと型付きの判定と確率を返すJevというモデルを紹介しました。その後、TypeSafeに新しく登録しようとしたら、画面には「Sorry, new signups are paused」と表示されており、新規登録が止まっていました(9月25日時点)。Vercelによると、JevはAI Gatewayに登場してから24時間で、過去のどのモデルよりも多くの有料チームに使われたそうです。すごい。現在は新規登録できないため、本記事のサンプルを実行できるのは、TypeSafeの既存アカウントを持つ人だけです。 このビッグウェーブに乗って私も自分でJev互換のモデルを作ってみたいと思ったので、まずはJevのAPIと手元のモデルを同じ題材で比べる環境を作ることにしました。 そして、すでに独自のJevライクモデルを公開している人たちもいます。KevはQwenの公開重みを追加学習したモデルで、LayaはModernBERT系。Tev1もQwenを使った学習方法を公開しています。私もKevを日本語データセットで追加学習して精度の変化を見たり、麻雀の「何切る」問題で検証したりしまし